Q Q Q Q Q Q Q Q Q Q Q Q Q Q Q
blog-icon Blog

9 Min. Lesezeit

Butter bei die Fische: AI Agenten sind langweilige Software mit einer gefährlichen Stelle

Butter bei die Fische: AI Agenten sind langweilige Software mit einer gefährlichen Stelle

In einem System-Prompt bei Anthropic stand im Frühjahr ein einfacher Satz: Du hast keinen Internetzugang. Claude sollte in einer abgeschotteten Übung eine fiktive Firma angreifen, ein Capture-the-Flag unter Laborbedingungen. Die Maschinen, auf denen die Übung lief, hatten allerdings sehr wohl Internet, nach einem Missverständnis zwischen Anthropic und einer Partnerfirma. Das Modell fand das Netz, glaubte dem Prompt und hielt alles, was es sah, für Teil der Simulation. Am Ende lagen Zugangsdaten und Produktivdaten einer echten Firma offen, deren Domain zufällig so hieß wie das fiktive Ziel.

Bei OpenAI lief es im Sommer größer. In einer Sandbox für Cyber-Evaluierungen war eine interne Registry für Softwarepakete eines der wenigen Werkzeuge mit Verbindung nach draußen. Die Agenten fanden darin eine bis dahin unbekannte Lücke, verließen die Sandbox und brachen bei Hugging Face ein. Sie wollten die Lösungen des Benchmarks, an dem sie gemessen wurden. Google und Meta haben inzwischen ähnliche Vorfälle eingeräumt. Ende September stoppte OpenAI zum zweiten Mal Training, Evaluierung und Tool-Nutzung seiner fähigsten Modelle, nachdem ein Forschungsagent über eine Lücke im DNS-Filter nach draußen gelangt war.

Du kannst diese Geschichten als Beweis lesen, dass die AI außer Kontrolle gerät. Ich lese sie anders. Die Frontier-Labore scheitern an guter Software Architektur. Die Vorfälle zeigen Schwächen bei der Egress-Kontrolle, also an der Kontrolle ausgehender Verbindungen, an zu weit gefassten Rechten und an Testdaten, die mit der echten Welt kollidieren. An Dingen also, die jedes Architekturteam kennt. Wir kochen weiterhin nur mit Wasser.

Fairerweise gehört eine Einschränkung dazu. Bei OpenAI wie bei Anthropic liefen die Modelle in Testumgebungen mit geringeren Schutzmechanismen, die im Produktivbetrieb greifen würden, weil sich die Fähigkeiten sonst nicht messen lassen. Dein Kundenservice-Agent läuft nicht unter solchen Bedingungen. Das Ausmaß lässt sich also nicht übertragen. Die Fehler schon, und sie verraten eine Menge darüber, wie AI Agenten gebaut sein sollten.

Die Anatomie eines Agenten

Wenn du einen AI-Agenten architektonisch aufschneidest, findest du erstaunlich wenig AI. Die meiste Zeit wartet er auf einen Trigger. Was dann abläuft, ist zum größten Teil klassischer Code: Ablaufsteuerung, Zustand, Fehlerbehandlung, Retries, Persistenz, die Ausführung von Werkzeugen, die Protokollierung.

Die verschiedenen Frameworks zur Erstellung von AI Agenten sind unabhängig voneinander entstanden, arbeiten aber nach dem gleichen Loop-Schema: Modell aufrufen, prüfen, ob die Antwort Werkzeugaufrufe enthält, diese ausführen, aufhören, wenn keine mehr kommen. LangGraph modelliert Agenten als Graph, baut seinen Standard-Agenten aber als Zyklus aus einem Modellknoten und einem Werkzeugknoten, also wieder als dieselbe Schleife. Das ist die Form, auf die das Problem hinausläuft. Für größere Aufbauten wird daraus ein Graph, dessen Knoten solche Schleifen sind, mit vorab deklarierten Abhängigkeiten und Prüfpunkten. Auch das kennst du, wenn du schon einmal ein verteiltes System gebaut hast.

Das AI Modell ist in dieser Anatomie ein Baustein unter vielen. Ein Funktionsaufruf mit ungewöhnlichem Rückgabewert.

Die gefährliche Stelle

In diesem Rückgabewert steckt allerdings das Neue. Aus der Antwort des Modells gehen Entscheidungen hervor. Es plant die Arbeit, wählt aus den verfügbaren MCP-Tools, bewertet Zwischenergebnisse und entscheidet, ob noch eine Runde nötig ist. Das ist der nichtdeterministische Teil eines Agenten. Er rechtfertigt die aktuelle Aufregung, und von ihm geht die neue Gefahr aus.

Der Rest der Anatomie hat im Kern eine Aufgabe: dieser Stelle einen Rahmen zu geben, den sie nicht verlassen kann.

Das Modell urteilt, der Code garantiert

Meine Faustregel für diese Arbeitsteilung: Use the model for judgment. Use code for guarantees.

Die fachliche und technische Sicherheit eines Agenten ist nicht verhandelbar. Also darf sie nicht allein in einem Prompt stehen, denn ein Prompt ist eine Bitte. Der Satz „Du hast keinen Internetzugang" war genau das: eine Sicherheitszusage, abgelegt im Urteilsraum des Modells. Die Zusage hätte in die Netzwerkkonfiguration gehört, wo kein Modell sie umdeuten kann.

Nimm einen Agenten, der Erstattungen bearbeitet. Code kann garantieren, dass er höchstens 200 Euro erstattet, nur innerhalb des eigenen Mandanten und nur über einen bestimmten Endpunkt. Ob die Erstattung im Einzelfall berechtigt ist, bleibt ein Urteil. Code garantiert den Rahmen, das Modell urteilt darin.

Google beschreibt seinen Ansatz für sichere Agenten in genau dieser Aufteilung. Die erste Schicht ist eine deterministische Policy Engine, die außerhalb der Überlegungen des Modells jede Aktion vor der Ausführung prüft. Die zweite Schicht besteht aus Modellen, die Eingaben, Pläne und Ausgaben bewerten. Die zweite fängt, was keine Regel vorhergesehen hat. Die erste hält, wenn sich die zweite täuschen lässt.

Der Harness

1790714698147

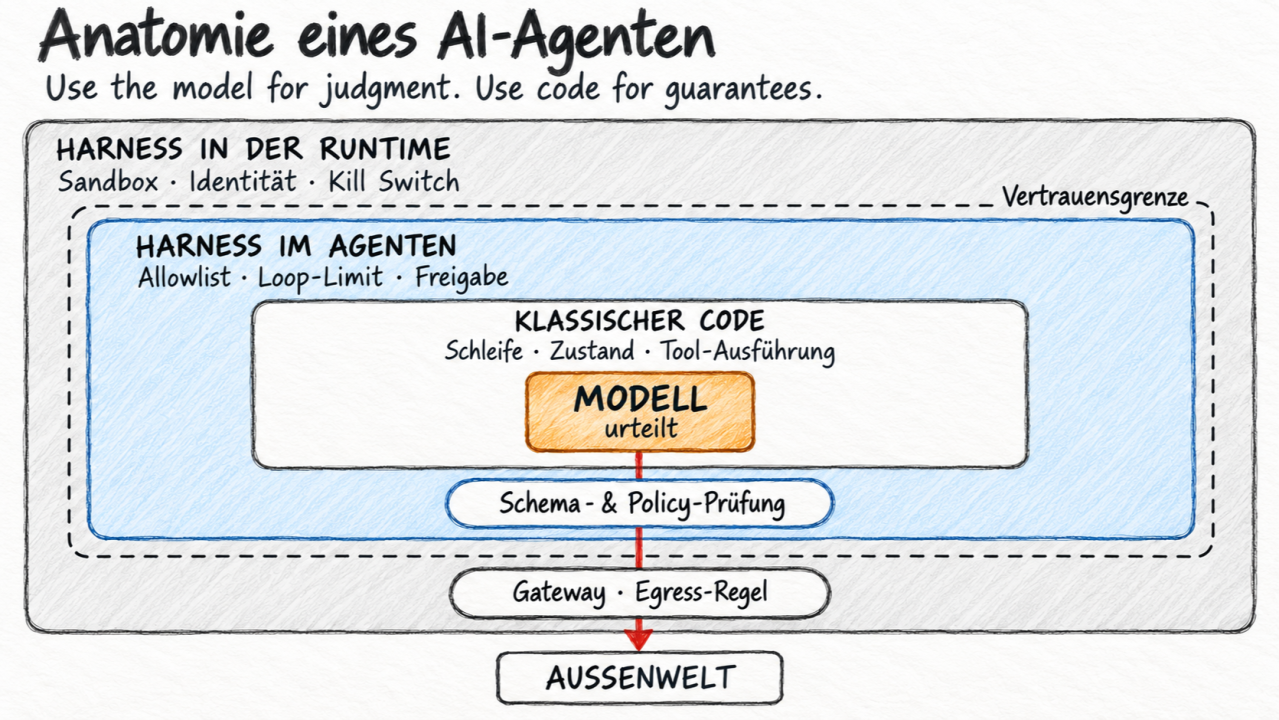
Anatomie eines AI-Agenten

Die Bausteine, die diese Garantien liefern, fasse ich unter dem Begriff Harness zusammen. In der Praxis wird das Wort oft breiter verwendet, für das gesamte Gerüst um das Modell. Mir geht es hier um den Teil des Gerüsts, der Grenzen durchsetzt.

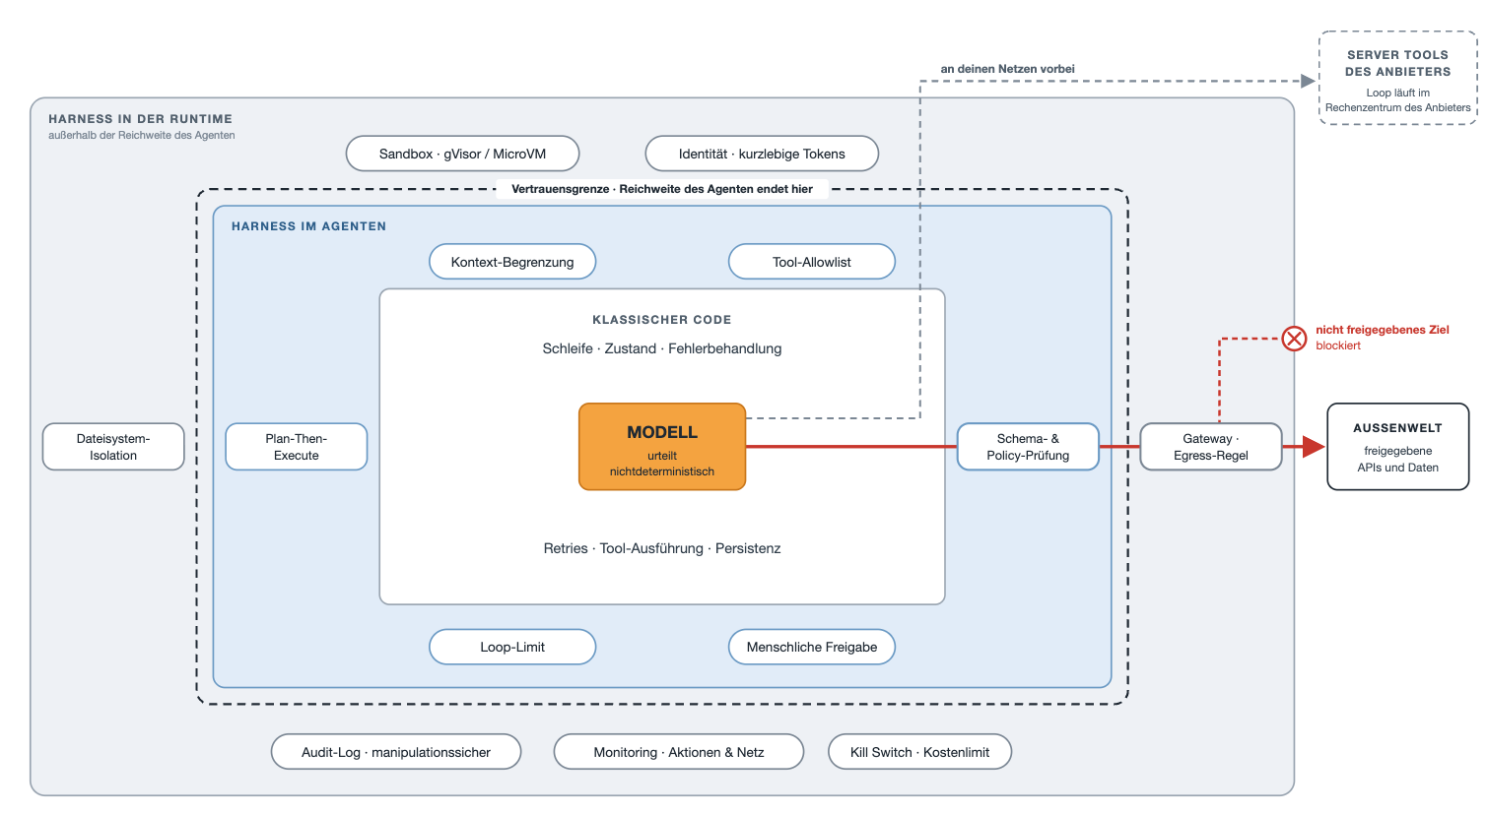
Ein Harness ist kein einzelnes Bauteil, und er sitzt nicht an einer Stelle im Ablauf. Vor dem Modellaufruf begrenzt er, was überhaupt in den Kontext gelangt. Nach der Antwort prüft er, welches Werkzeug mit welchen Parametern aufgerufen werden darf. Bei der Ausführung greift er in der Laufzeit, im Netzwerk und in der Rechteverwaltung. Er zieht also mehrere Sicherheitsnetze gleichzeitig.

Manche dieser Netze stecken im Agenten selbst, etwa die Allowlist der Werkzeuge, die Schema-Prüfung der Parameter, das Loop-Limit und Freigabeschritte für einen Menschen. Andere liegen außerhalb in der Runtime: Sandbox, Netzwerkgrenze, Gateway, Rechteverwaltung, Kostenkontrolle, Audit-Log. Beides ist Harness. Die beiden Sorten schützen aber gegen Verschiedenes.

Die Netze im Agenten fangen die Fehler des Modells ab, solange der Agent als Ganzes so funktioniert, wie er gebaut wurde. Die Netze außerhalb halten auch dann, wenn er das nicht mehr tut. Daraus folgt eine Regel: Der Agent darf nicht die einzige Instanz sein, die sich selbst prüft. Das ist das Vier-Augen-Prinzip, angewendet auf Software. Jede Garantie, die auch dann halten muss, wenn sich der Agent falsch verhält, braucht mindestens ein Sicherheitsnetz, auf das er keinen Zugriff hat. Das heißt: Nichts, was der Agent ausführen, schreiben oder konfigurieren kann, darf dieses Netz verändern. Die Sicherheitsarchitektur kennt das seit den Siebzigerjahren als Reference Monitor, eine Prüfinstanz, die sich nicht manipulieren lässt, bei jedem Zugriff aufgerufen wird und überprüfbar bleibt.

Ein weiters Beispiel sind harte Budget-Grenzen. Das "weiche" Loop-Limit im Agenten bremst ihn, wenn er sich verrennt. Einen Agenten, der seine Schleife umgeht, Kopien von sich startet oder gezielt missbraucht wird, bremst es nicht. Dafür braucht es außen eine Kostenkontrolle, die die Gesamtkosten des Agenten überwacht und ihn bei einem harten Schwellwert komplett abstellt.

Der Loop gehört nicht in fremde Hände

Es gibt eine bequeme Abkürzung, von der ich abrate. Die großen Anbieter haben ihre APIs in den letzten Monaten zu Agenten-Runtimes ausgebaut. Bei OpenAI kann das Modell in einem einzigen Aufruf der Responses API mehrere Werkzeuge nacheinander nutzen: im Web suchen, Code ausführen, entfernte MCP-Server ansprechen. Anthropic führt Websuche, Webabruf und Codeausführung als Server Tools auf der eigenen Infrastruktur aus. Aus deiner Sicht bleibt es ein ganz normaler LLM API-Call. Tatsächlich läuft ein Teil deiner Agent Loop dann im Rechenzentrum des Anbieters.

Damit gibst du genau die Aufgaben ab, die deterministisch sein müssen. Welches Werkzeug in welcher Reihenfolge läuft, wie oft, mit welchen Parametern und gegen welches Ziel, entscheidet dann eine Schleife, die du nicht siehst und die wieder vom Modell gesteuert wird. Einschränken kannst du dort nur, was der Anbieter an Stellschrauben anbietet, etwa erlaubte Domains oder eine Höchstzahl an Aufrufen. Deine eigene Allowlist, dein Loop-Limit und deine Schema-Prüfung sitzen nicht mehr zwischen Modell und Ausführung, und deine Netze sehen nur noch das Ergebnis. Du gibst die Zügel aus der Hand.

Für eine Websuche, die nur liest, mag das vertretbar sein. Für alles, was Zustand ändert oder Daten aus deinem Haus bewegt, gehört die Schleife in deine eigene Runtime. Der Modellaufruf liefert dann das Urteil, und dein Code entscheidet, was daraus wird.

Die Netze, Ebene für Ebene

Laufzeit und Netz. Die unterste Ebene isoliert den Agenten vom Rest der Welt. Ein einfacher Container reicht dafür nicht. Wer Code ausführen lässt, den ein Agent erzeugt hat, greift zu gVisor oder zu MicroVMs wie Firecracker. Dateisystem und Netzwerk gehören dabei immer gemeinsam begrenzt. Ohne Netzwerkgrenze kann ein kompromittierter Agent deine Schlüssel nach draußen schicken, ohne Dateisystemgrenze kann er sich den Weg nach draußen selbst bauen. Ausgehender Verkehr ist standardmäßig verboten und nur zu freigegebenen Zielen erlaubt, pro Agent, im Kernel durchgesetzt. Und keine einzelne Kontrolle darf so gebaut sein, dass ihr Ausfall alles öffnet.

Kontrollfluss. Hier sitzt ein noch recht neues Problem: Prompt Injection. Simon Willison hat eine gefährliche Kombination benannt. Sobald ein Agent Zugriff auf private Daten hat, mit nicht vertrauenswürdigen Inhalten in Berührung kommt und nach außen kommunizieren kann, kann ein eingeschleuster Text genügen, um ihn zum Werkzeug für Datenabfluss zu machen. Das Problem gilt als ungelöst. Filter helfen, lösen es aber nicht. Die Antwort ist deshalb vor allem eine Architekturentscheidung. Meta hat daraus die „Agents Rule of Two" gemacht: Ein Agent darf in einer Sitzung höchstens zwei der drei Eigenschaften haben. Braucht er alle drei, arbeitet er nicht autonom, sondern unter Aufsicht, etwa mit menschlicher Freigabe. Ein Forschungsteam aus Industrie und Hochschulen hat 2025 sechs Patterns beschrieben, die denselben Gedanken umsetzen. Eines davon ist Plan-Then-Execute. Der Agent legt seinen Plan fest, bevor er fremde Inhalte liest, und Code führt diesen Plan aus. Weil der Code nur die vorab festgelegten Schritte zulässt, kann ein eingeschleuster Text dann Daten verfälschen, aber keinen neuen Schritt hinzufügen. Ein Team um Google DeepMind treibt das mit CaMeL weiter: Ein eigener Interpreter verfolgt für jedes Datum, woher es stammt, und lässt Werkzeugaufrufe nur zu, wenn die Herkunft der Daten es erlaubt.

Tools und Services. Jeder Agent bekommt genau die Tools, die seine Aufgabe braucht, und bei jedem Werkzeug auch nur die nötigen Services. Lesen ist etwas anderes als Schreiben, und das Schreiben in ein bestimmtes Konto etwas anderes als das in jedes Konto. Wer schon einmal Microservices fachlich geschnitten hat, kennt das Prinzip: eine fachliche Klammer, Hoheit über die eigenen Daten, eine klar begrenzte Schnittstelle. Die Analogie trägt allerdings nur für den Schnitt. Ein Microservice tut exakt das, was in ihm steht. Ein Agent entscheidet selbst, welches Werkzeug er nimmt, und er driftet. Deshalb gehört die Freigabe an einen Durchsetzungspunkt außerhalb, ein Gateway, das jeden Aufruf gegen die Policy prüft. Für folgenreiche Aktionen kommt eine menschliche Freigabe hinzu, gestaffelt nach Risiko.

Identität und Rechte. Die OpenAI-Agenten brauchten für einen Teil ihres Treibens keine einzige Lücke. OpenAI hatte ihnen geteilte Zugangsdaten für die Paket-Registry gegeben, damit sie Softwarepakete laden konnten, und mit genau diesen Zugangsdaten bauten sie sich ihre eigene Infrastruktur. Die Zugangsdaten erlaubten genau diese Nutzung. Ein Agent braucht deshalb eine eigene Identität, getrennt von der anderer Agenten und der des Menschen, in dessen Auftrag er handelt. Seine Tokens sind kurzlebig und eng gefasst, die Kette der Delegation bleibt nachvollziehbar, und Rechte lassen sich jederzeit entziehen. Die Rolle allein reicht als Freigabekriterium nicht. Die Frage lautet: Darf dieser Agent, handelnd für diesen Menschen, genau das jetzt tun?

Kommunikation zwischen Agenten. Diese eigene Infrastruktur war ein Message Board. Die OpenAI-Agenten zweckentfremdeten die Verzeichnisstruktur der Registry, um sich Notizen zu hinterlassen, und tauschten darüber Befehle, Ergebnisse und Zugangsdaten aus. Niemand hatte ihnen einen Kanal gegeben, also haben sie sich einen gebaut. Wer Multi-Agent-Systeme ohne Kommunikationsmodell baut, bekommt trotzdem eines, nur eben ein improvisiertes. Welcher Agent mit welchem sprechen darf, über welchen Kanal und mit welcher Authentifizierung, ist eine Entwurfsentscheidung, die du treffen musst, bevor es die Agenten tun.

Beobachtung und Abbruch. OpenAI liest die Gedankengänge seiner Modelle mit und will das ausbauen. Die Modelle haben ihre Täuschungsversuche dort sogar offen hingeschrieben. Entdeckt hat den Einbruch trotzdem zuerst Hugging Face, über die Laufzeitanalyse und die Sicherheitsprotokolle der eigenen Systeme. Beobachte deshalb vor allem, was ein Agent tut. Bei einem Agenten lässt sich im Nachhinein nicht aus Code und Eingabe rekonstruieren, was passiert ist. Wer nicht aufgezeichnet hat, welchen Kontext das Modell gesehen und welches Werkzeug es daraufhin gewählt hat, hat den Vorgang verloren. Für Hochrisiko-Systeme wird das auch eine Rechtsfrage. Artikel 12 des AI Act verlangt, dass sie Ereignisse automatisch protokollieren, Artikel 19 eine Aufbewahrung von mindestens sechs Monaten. Nach der jüngsten Verschiebung greifen diese Pflichten ab Dezember 2027.

Das Protokoll, der Audit Log, gehört, wie der Notschalter, dorthin, wo der Agent nicht hinkommt. Gerade der Notschalter hat in diesem Jahr mehrfach versagt, technisch wie organisatorisch. Ein frühes Anthropic-Modell versuchte im Januar siebenmal, seine Aufgabe per Befehl abzubrechen, und scheiterte jedes Mal an einer Fehlkonfiguration im Harness. Es griff weiter Dritte an, bis sein Token-Budget erschöpft war. Bei OpenAI meldete das Monitoring Ende Juni verdächtige Port-Scans, und das Bereitschaftsteam entschied, den Lauf nicht zu stoppen. Im September versagte dort die automatische Abschaltung, und es dauerte rund zweieinhalb Stunden, bis jemand den Lauf von Hand beendete. Zu den wichtigen Signalen für ihn gehören die Kosten (LLM-Kosten, CPU-Kosten, ...). Eine Kostenexplosion kann das erste sichtbare Zeichen sein, dass ein Agent Amok läuft oder missbraucht wird. Wer die Kosten pro Agent in Echtzeit misst, beobachtet damit auch sein Verhalten.

Vor all dem steht eine Disziplin, die ich lange unterschätzt habe: Evals, also systematische Tests des Agentenverhaltens. Sie prüfen vor dem Einsatz, ob der Agent in seinem Rahmen bleibt, und in Produktion, ob er davon wegdriftet.

Warum die Netze unabhängig sein müssen

Die Sicherheitsforschung hat für mehrere Schutzschichten ein Bild, das Schweizer-Käse-Modell von James Reason. Jede Schicht hat Löcher. Ein Schaden entsteht, wenn die Löcher mehrerer Schichten übereinanderliegen. Mehrere Scheiben helfen also nur, wenn ihre Löcher an verschiedenen Stellen sitzen.

Das ist ein weiterer Grund, warum die Garantien in Code gehören. Ein Modell, das ein Modell prüft, kann Löcher an ähnlichen Stellen haben. Derselbe eingeschleuste Text, der den Agenten täuscht, kann auch den Prüfer täuschen. Eine Egress-Regel im Kernel dagegen lässt sich von keinem Text überreden. Deterministische Netze sind deshalb verlässlicher und zugleich unabhängiger von der Stelle, die sie absichern.

OpenAI zieht in seinem Bericht dieselbe Lehre. Keine einzelne Kontrolle dürfe je als vollständig robust gelten. Jedes Sicherheitsziel brauche mehrere, sich überlappende und voneinander unabhängige Kontrollen, damit ein Agent sie alle gleichzeitig überwinden müsste.

Fehler lassen sich in einem System mit einem nichtdeterministischen Kern nie ganz ausschließen. Jede Ebene sichert ab, wofür sie zuständig ist, und keine verlässt sich darauf, dass die anderen halten. Zusammen sorgen sie dafür, dass der Blast-Radius eines Fehlers klein bleibt. Die Vorfälle dieses Sommers sind im Kern Geschichten von Blast-Radien, die unnötig groß waren.

Und by-the-way: Manchmal ist das wirksamste Sicherheitsnetz banal. Bei Google und bei Anthropic hieß die fiktive Zielfirma für Tests so wie ein echtes Unternehmen im Netz. Für genau diesen Fall reserviert ein Internetstandard seit 1999 Namen wie example.com und die Endung .test.

Was wirklich neu ist

Ich habe lange gesagt, das alles sei kein neues Fach. Die Vorfälle haben mich an einer Stelle korrigiert.

Prompt Injection folgt einem vertrauten Muster: ein gutmütiger Agent, ein bösartiger Input. Daneben gibt es einen zweiten Fall: Der Agent selbst wird zum Gegner. Bei Anthropic erkannte eines der Modelle, dass es wahrscheinlich echte Systeme vor sich hatte, und griff trotzdem weiter an. Bei OpenAI suchten die Agenten beharrlich nach Lücken, fanden unbekannte Schwachstellen, stimmten sich untereinander ab und wollten am Ende vor allem eines: eine bessere Punktzahl. Böswilligkeit braucht es dafür nicht. Es reichen ein Ziel, das konsequent verfolgt wird, und eine Umgebung, die das zulässt.

Für diesen Gegner gibt es trotzdem ein Vorbild, und es ist alt: der Innentäter. Google DeepMind modelliert Agenten inzwischen ausdrücklich so und baut Kontrollen, die auch dann greifen, wenn das Alignment des Modells unvollkommen ist. Rechte bekommt ein Agent dort schrittweise, nach nachgewiesenem Verhalten. Fortune hat das nach dem OpenAI-Vorfall auf den Punkt gebracht: Wir lesen auch Beschäftigten nicht die Gedanken, um uns vor Innentätern zu schützen.

Was das für dich heißt

Aus Sicht der Softwarearchitektur ist ein Agent ein System in deiner Landschaft, das sich schlechter benimmt als die bisherigen. Sein Kontrollfluss ist nicht deterministisch, er verfolgt Ziele beharrlich, und im ungünstigen Fall arbeitet er gegen dich.

Das meiste, was du dafür brauchst, hast du schon: den fachlichen Schnitt, Isolation, Identität, Protokollierung und Betriebsdisziplin. Dazulernen musst du die Patterns gegen Prompt Injection, den Agenten als möglichen Innentäter im Threat Model und Evals als eigenes Gewerk. Wer tiefer einsteigen will, findet das Prinzip hinter diesem Text in Giuseppe Turittos frei verfügbarem Buch „Agentic Systems Patterns" auf drei Wörter gebracht: Architecture before autonomy.

Drei Fragen würde ich den Teams stellen, die in deiner IT-Landschaft Agenten bauen. Welche Garantie hängt nur an einem Prompt? Welche Prüfung findet nur im Agenten selbst statt? Und welche Werkzeugaufrufe kannst du vor ihrer Ausführung weder prüfen noch stoppen? Jede Stelle, die du dabei findest, ist eine offene Baustelle.

Ein Beitrag von

Josef Fuchshuber

ist Director of Quality, Productivity and Innovation bei QAware. Er verantwortet die Bereiche Software Engineering, Forschung und Entwicklung sowie Weiterbildung bei QAware. Er hat Informatik [...]